映像処理からAI推論までを組み合わせる「Xylon Vision AI Framework」
こんにちは、小野です。
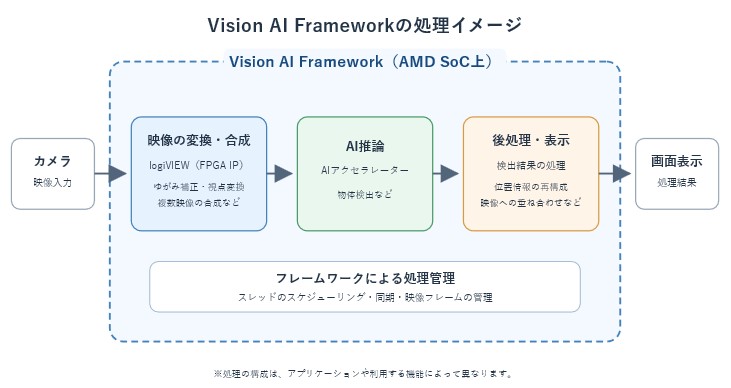
車載カメラの映像から歩行者や周囲の車両を検出し、運転支援に活用するシステムや、ロボットのカメラ映像から障害物を認識し、動作に反映するシステムがあります。こうしたシステムでは、カメラ映像の歪みを補正したり、AIが認識しやすい形に変換したりしたうえで、AIで物体を検出し、その結果を映像に重ねて表示します。映像の変換からAI推論、結果表示までの処理の流れを作る必要があります。
このような処理の流れを、AMD社のSoC(※1)やFPGA上で構成する開発を支援するのが、Xylon社の「Vision AI Framework」です。OKIアイディエスは、クロアチアのXylon社の国内代理店として、同フレームワークを取り扱っています。あらかじめ用意されている機能ブロックを組み合わせることで、映像処理からAI推論、結果出力までの処理の流れを作れます。FPGAの知識がなくても、専用のFPGA開発ツールを使わずに、FPGAの開発ができます。
Vision AI Framework を使って開発された「Surround View AIデモ」は、8月末に開催されたAMD社主催の展示会「AMD Embedded Computing Summit 2026 (AMD ECS2026)」でも紹介され、多くの来場者にご覧いただきました。
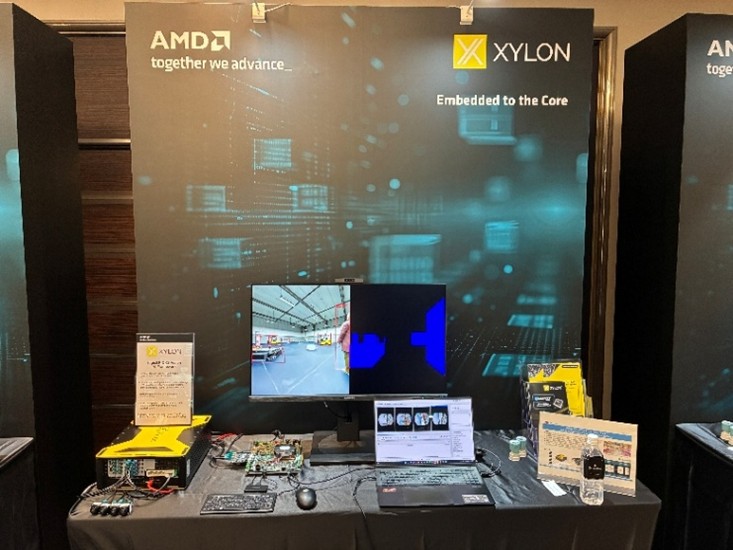
AMD ECS2026で展示したSurround View AIデモ
今回は、Vision AI Frameworkの概要と、展示会で紹介したXylonのSurround View AIデモについてご紹介します。
以前のブログで、XylonのISP IPコア「logiISP」を紹介してくれましたよね。カメラのイメージセンサーが捉えた画像データを目で見て人が自然に感じるような画像へ仕上げるIPコアでした。
はい。AMD社製のSoCや FPGA向けのIPコアです。セキュリティや医療などの分野で活用できます。カメラからの映像を、AIが物体検出(※2)しやすいように加工することもできますよ。
AIモデルの実装だけでなく、映像入力時の前処理、認識結果を表示する後処理の設計、さらに開発ツールの使い方の習得なども必要になると思います。
確かに。開発者は、FPGA設計や映像処理の仕組みを一から作る負担を減らして、カメラやAIモデル、アプリケーション固有の処理に注力したいですよね。
そこで、AMD社のSoCやFPGAで、映像処理からAI推論、結果表示までの処理の流れを構成する開発を支援する、Xylonの「Vision AI Framework」を今日はご紹介します!
このフレームワークを使うと、映像処理からAI推論、結果の表示までの開発を、どのように進められるのでしょうか?実際の開発の流れに沿って教えてください。
Vision AI Frameworkとは?
XylonのVision AI Frameworkは、AMD社の SoC上で、カメラ映像の処理からAI推論、結果の表示までを組み合わせたアプリケーションを開発するためのフレームワークなんですよね。このフレームワークには、映像処理やAI推論に必要な機能が、ひととおり揃っているんですか?
はい。映像の変換や複数カメラ映像の合成などに使える機能ブロックが用意されています。たとえば、Xylonの「logiVIEW」を用いて、こうした映像処理を行えます。必要な機能ブロックをつなぎ、アプリケーションの処理の流れを構成できます。
カメラ映像を、AIモデルの入力条件に合わせて整えるんですね。
そのとおりです。映像処理に加えて、AI推論を行う処理や、推論結果を映像に重ねて表示する処理も組み込めます。また、あらかじめ用意された機能ブロックだけでなく、ユーザー独自の機能ブロックを追加して拡張することもできます。

必要な処理を一からすべて作るのではなく、Vision AI Frameworkで用意された機能ブロックをつないで、開発したいアプリケーションに必要な処理の流れを構成できるんですね。
はい。さらに、複数の処理を並行して動かすための仕組みや、処理間で映像データを受け渡す機能も備えています。これにより、開発者がデータ連携や処理の同期を一から実装する負担を抑えられます。
処理の流れを作れるだけでなく、複数の処理を並行して動かすこともできるんですね。複雑な処理の流れも、効率的に作り込めそうです。
そうですね。Vision AI Frameworkはオープンソースで、機能の変更や拡張、ほかのシステムへの統合もできます。次に、どのような機能ブロックが用意されているのか、もう少し具体的に見ていきましょう。
用途に合わせて組み合わせる機能ブロック
Vision AI Frameworkには大きく分けると、カメラ映像を変換する機能、複数のカメラ映像を合成する機能、AI推論や画面表示を行う機能などがあります。用途に合わせてこれらの機能ブロックをつなぎ、必要な処理の流れを構成することができるんです。
たとえば、カメラ映像を変換する機能ブロックには、どんなものがありますか?
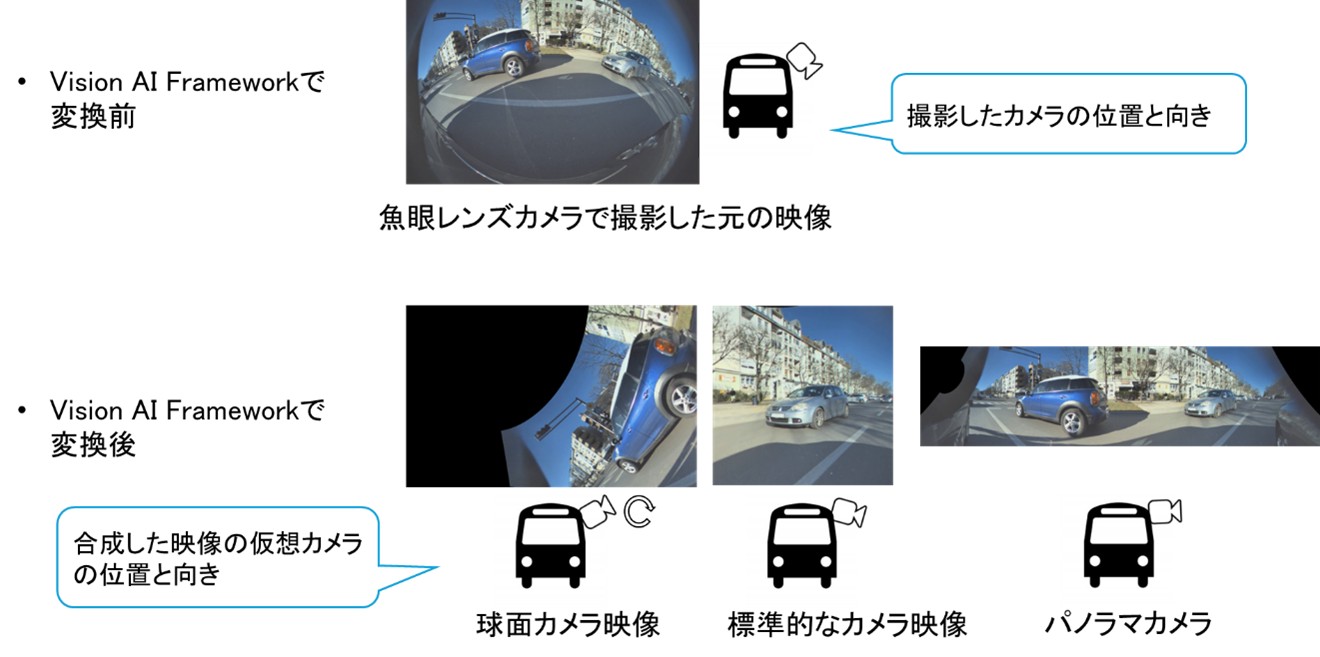
1台のカメラ映像を、用途や視点に合わせて変換する機能があります。たとえば、魚眼カメラの映像を円筒投影(魚眼映像を、横方向に広い視野の映像に変換する処理)に変換したり、解像度や画角を調整したりできます。複数のカメラ映像をつなぎ合わせて、俯瞰映像などを作る機能もありますよ。
カメラの映像をそのまま使うのではなく、AIモデルや表示方法に合わせて変換できるんですね。その機能をうまく使えば、俯瞰映像、つまりサラウンドビュー映像も作れるんですね。
そうです。さらに、魚眼カメラの映像の歪みを補正し、AIモデルが認識しやすい形に変換する使い方も考えられます。ただし、変換結果を開発者が意図した通りに得るには、カメラのレンズや設置位置の校正が必要です。また、どの変換が適切なのかは、カメラやAIモデル、用途に応じて開発者が確認します。

撮影した元の映像と生成する映像の一例
上の図は、魚眼レンズ搭載のカメラで撮影した元の画像とVision AI Frameworkで加工した後の画像との比較です。
魚眼カメラの映像を、用途に応じた見え方に変換できるんですね。変換した映像をAIへ入力して、推論した結果を映像に重ねて表示するところまで構成できるんですか?
はい。DNN(※3)による物体検出を行い、検出した物体の情報を映像に重ねて表示するようなアプリケーションを構成できます。表示には2D・3D描画の機能も利用でき、マウスやキーボードの入力を受け付ける機能も用意されています。
映像の変換に加えて、AIによる物体検出や、その結果の表示まで、1つのアプリケーションとして構成できるんですね。
また、実行中にあらかじめ設定した処理を切り替える機能もあります。アプリケーションを再起動せずに処理の流れを変更できます。
映像処理や処理間のデータ受け渡しに必要な機能を使いながら、用途に合わせた処理を組み立てられるんですね。実際に、こうした機能がどのように使われているんでしょうか、気になります。
では次の章で、Surround View AIデモを例に、カメラ映像の変換からAI推論、結果の表示まで、具体的な処理の流れを見ていきましょう。
Surround View AIデモで見られる処理
Surround View AIデモは8月末に開催されたAMD ECS2026で展示されていたと聞きました。これってどんなデモなんですか?
下の写真は、AMD ECS2026に展示していた実際のデモの様子です。
写真左下のAMD社製評価ボードで4つのカメラの映像データを受信します。評価ボードにはVision AI Frameworkで作成したSurround View AIが搭載されており、処理された映像にAIの推論結果が重畳され、ディスプレイに表示されます。
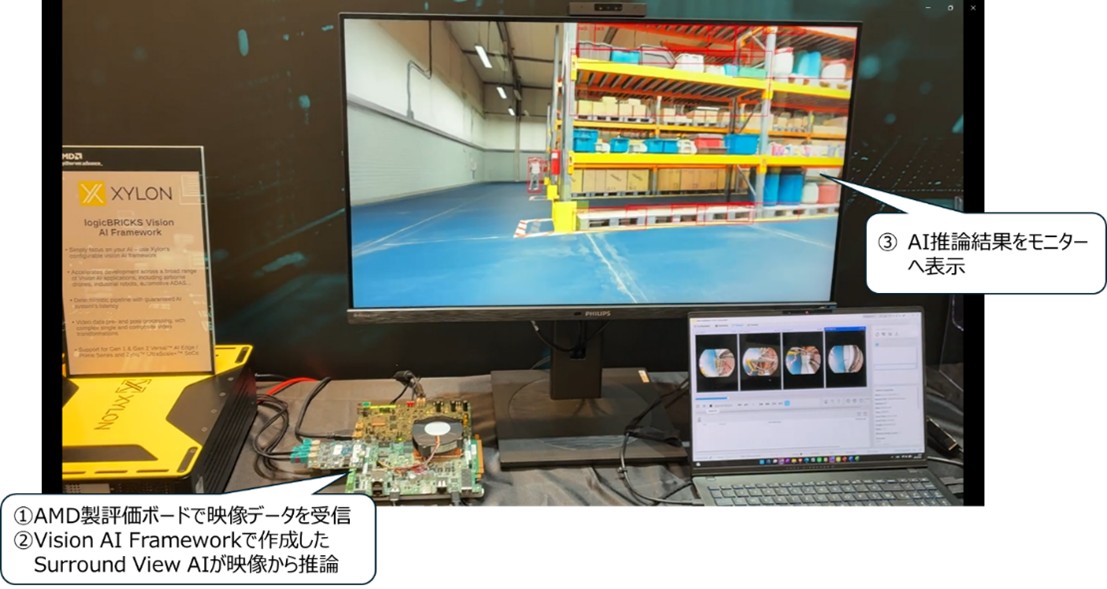
AMD ECS2026で展示したSurround View AIデモ
ふむふむ。どんな映像処理やAI処理がされているんですか?
このデモでは、映像処理やAI処理、結果表示の内容が異なる4つのモードを切り替えて確認できます。評価ボードに接続したキーボードから切り替えることができます。
なるほど。Vision AI Frameworkで映像処理やAI処理はどのような流れで行われるんですか?

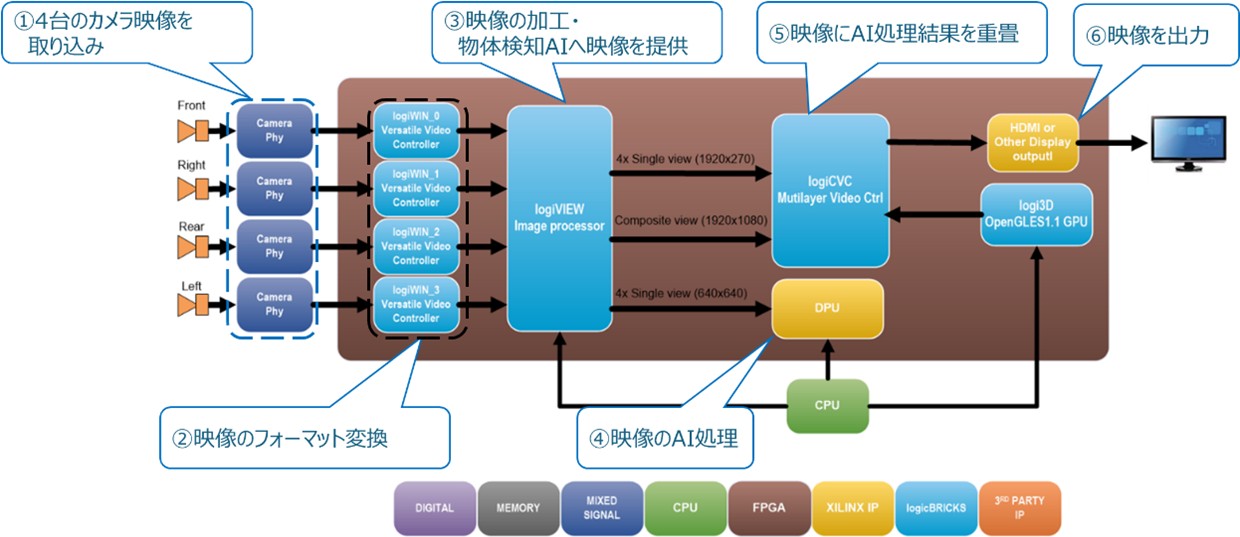
Vision AI Frameworkデモのブロック図
こちらの図は、Vision AI Frameworkデモのブロック図です。図中の吹き出しの番号順に、アプリケーションの処理が進みます。4台のカメラから受け取った映像は、Vision AI Frameworkで利用するIPコア「logiVIEW」で処理します。logiVIEWは、カメラレンズによる映像の歪みを補正します。AIが処理できる形へカメラ映像を加工し、その映像に対してAI推論を行います。
モードごとに映像変換やAI処理、結果の表示内容が異なり、デモで見られる処理も変わるんですよね。各モードでは映像をどのように処理し、AIで何を検出するんですか?
各モードの主な処理と表示内容を下記にまとめましたのでご覧ください!
ブログの文末にXylonがVision AI Frameworkを紹介しているYouTube動画へのリンクがありますので、気になる方はぜひそちらもご覧ください。
モード1:カメラ映像から物体検出
- 処理:車両の前後左右に搭載された4つのカメラからの入力画像をVision AI Frameworkでそれぞれ円筒投影に変換し、人や車などの物体を検出
- 表示:前後左右4つのカメラ映像と、映像上に重ねた検出結果
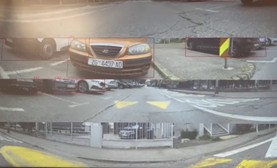
デモモード1の様子
モード2:物体の位置や障害物マップを表示
- 処理:車両の前後左右に搭載されたカメラ映像の円筒投影への変換、交通物体の検出、TOR(Traffic Object Reconstruction)による物体位置の再構成、OMAP(Obstacle Map)の生成
- 表示:検出結果を重ねた俯瞰合成映像と、TOR・OMAPの可視化結果
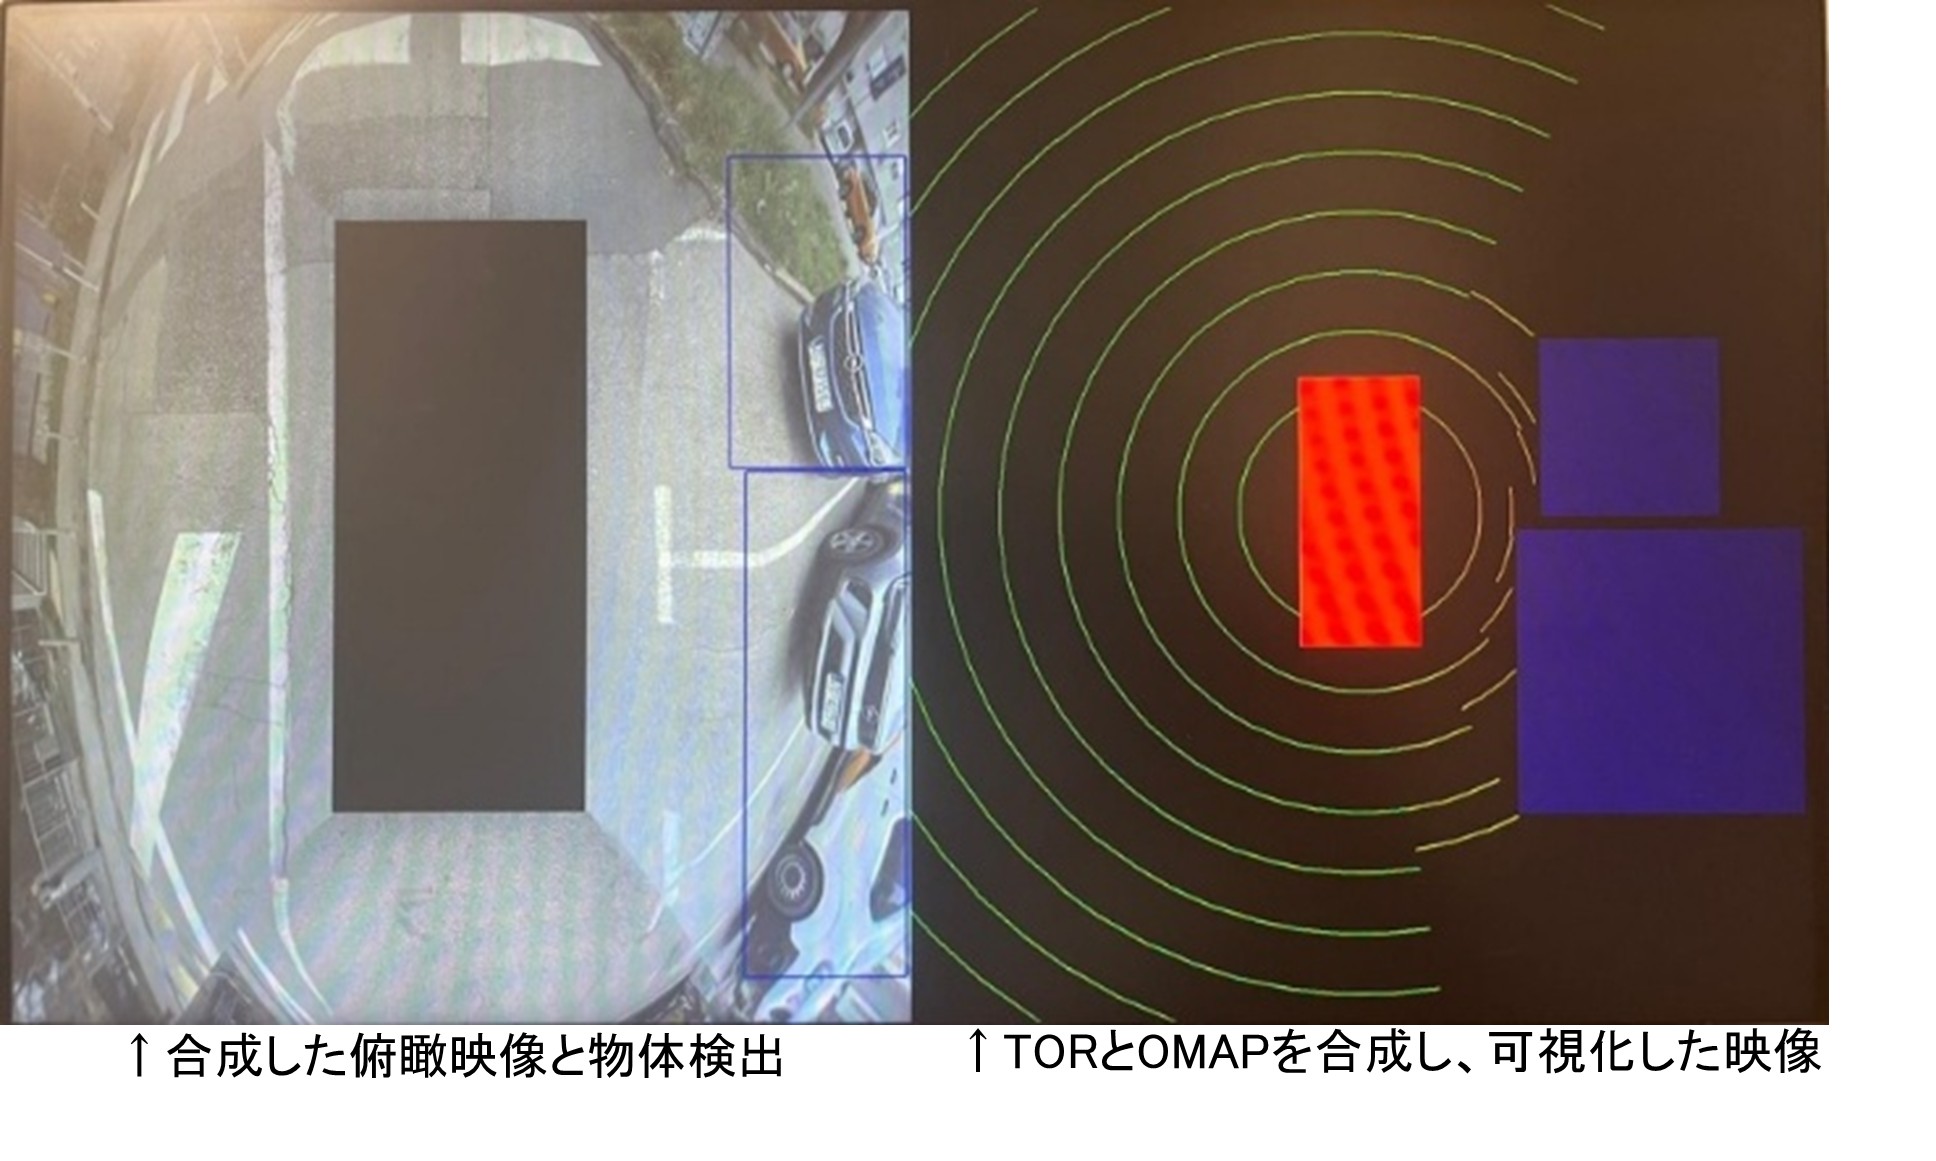
デモモード2の様子
モード3:駐車スペースを検出
- 処理:車両の前後左右に搭載されたカメラからの入力画像をlogiVIEWで俯瞰の合成映像に変換し、NPU(※4)で駐車スペースを検出
- 表示:検出結果を重ねた俯瞰合成映像
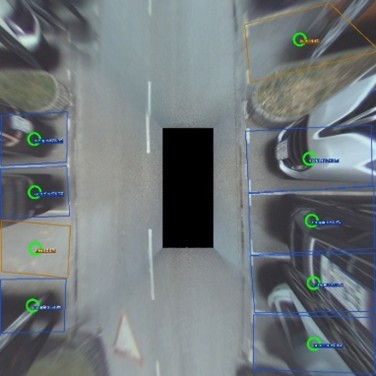
デモモード3の様子
モード4:物体検出+サラウンドビュー
- 処理:入力画像をlogiVIEWで円筒投影に変換し、NPUで物体を検出。その後、後処理で検出物体の位置を再構成
- 表示:操作によって、視点を回転させたり俯瞰表示に切り替えたりできる。検出した物体を映像に重ねて表示。下の画像では、正面カメラの映像から倉庫内の物体を認識し、バウンディングボックスを重畳している。
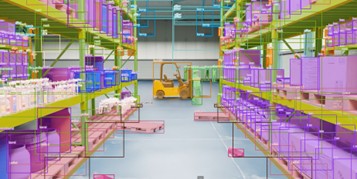
デモモード4の様子
モード4のデモの写真は、倉庫のものですよね。自動車以外でも利用できるということですか?
はい。ちなみに、モード4の倉庫は実際に撮影されたものではなく、シミュレータソフトで作成した倉庫の映像データを魚眼カメラの映像データとしてVision AI Frameworkデモに取り込んだものです。
このように、実は自動車以外にも、ロボットや産業機器の周辺監視、監視システム、医療用画像の処理など、カメラ映像をAIで分析する用途が想定されています。次に、想定される活用分野を見ていきましょう。
どのような分野で活用できる?
デモでは、車両や歩行者の検出や駐車スペースの検出などを見られるんですね。こうした映像処理は、自動車以外の分野でも活用できるのでしょうか?
はい。カメラ映像をAIで分析する用途は、さまざまな分野で想定されています。たとえば、次のような用途があります。
- ロボティクス・産業
- 医療
- 自動車
- ・ADASや自動運転
- ・車内で運転者や乗員の状態を確認するDMS(Driver Monitoring System)
- 防衛・航空宇宙
- ・UAV(無人航空機)の映像処理
- ・監視・物体追跡
自動車だけでなく、ロボットや産業機器、医療など、幅広い分野でカメラ映像を活用できるんですね。
そうです。実際に適用する際は、カメラの種類や設置環境、AIモデル、システムの要件に合わせて、映像処理やAI推論の構成を検討します。Vision AI Frameworkは、用途に応じた映像処理やAI推論を含むアプリケーションの開発に利用できます。
開発を始めるための提供内容
実際に評価や開発を始める場合、どのようなものが用意されているのでしょうか?
AMD社製評価ボード(VEK280 Versal AI Edge評価プラットフォーム、VEK385 Versal Gen2 AI Edge評価プラットフォーム)向けに、AMD Vivado Design Suite(※5)で利用できるリファレンスデザインやソフトウェアなどが提供されています。
なるほど、FPGAのデザインなどが用意されているのは心強いです。FPGA設計に関する知識や技術がない開発者でも、これらを使えば映像処理やAI処理の設計や評価を始めやすくなりそうです!
はい。Vision AI Frameworkの主な提供内容は次の通りです。
- ハードウェア設計
- ・AMD 社製評価ボード向けのリファレンスデザイン
- ・Xylonの評価用IPコア
- ・AMD Vivado Design Suiteで利用できる設計データ
- ソフトウェア設計
- ・AI推論の例を含むデモアプリケーションのソースコード
- ・Xylon社製IP用のライブラリーやドライバーなどを含むYocto(※6)ビルド環境
- ドキュメント
- オプション
- ・カメラ接続用のXylon社製FMCボード
- ・Xylon社製GMSL2カメラや接続用ケーブル
- ・技術サポート、コンサルティング、設計サービス
- ※AMD社の評価ボードは、販売代理店からの購入をお願いしています。
評価用ハードウェアや技術サポートなどをどこまで利用するかは、開発の目的や必要な環境によって異なります。提供内容やオプションの詳細は、導入を検討する際に確認することが大切です。
Vision AI Frameworkを使った開発を検討する際、当社とXylon社は目的に合わせて必要な構成のご提案を行っています。「何から検討したらいいかわからない…。」「どのような開発が必要になるのか…」とお悩みのお客様でも安心してお使いいただけるよう全力でサポートします。
最後に
Vision AI Frameworkは、カメラ映像の変換や合成からAI推論、結果の表示までを組み合わせられる開発基盤なんですね。デモを見ると、物体検出や駐車スペースの検出など、活用のイメージもつかみやすそうです。
このVision AI Frameworkは、FPGAの専門知識がなくても、AIの知識がある技術者なら扱うことができるように設計されています。AIに映像を渡す前の下準備から、その結果の見せ方までを組み合わせて開発できます。
とはいえ、AIに映像を渡せば、あとは全部おまかせ…とはいかないですよね。カメラの設置位置やレンズに応じて映像変換の条件を調整したり、AIモデルの入力条件に合わせて映像を整えたり、実際の環境で認識精度を確かめたりする必要がありますよね。そこは、設計者が判断する部分ですね。
そのとおりです。Vision AI Frameworkを使うことで、カメラ映像の変換からAI推論、結果の表示までを組み合わせてアプリケーション開発ができます。開発者は、途中で必要な画像処理を一から作り込む負担を抑えられるため、用途に応じてどのような映像変換を行い、AI推論とどう連携させるかといった設計に注力できます。
OKIアイディエスは、Vision AI Frameworkを国内代理店として取り扱っています。カメラ映像を使ったAIシステムの開発や、評価環境の導入を検討されている方は、ぜひお気軽にご相談ください。
Vision AI Frameworkが動作している様子は、Xylon社のYouTubeでもご覧いただけます。ぜひご覧ください。
Xylon YouTubeのリンク:
おまけ:専門用語解説コーナー
「この記事、専門用語てんこ盛りだな~」と思ったあなたのために、簡単に解説します!
※1: AMD SoC(System on Chip):AMD社が提供する、CPUなどの処理機能や、用途に応じて構成できるハードウェア機能を1つのチップに集積したもの。
※2: 物体検出:画像や映像の中から、人や車などの物体を見つけ、その種類と位置を特定する処理。検出した位置は、四角い枠(バウンディングボックス)で示すことが多い。
※3: DNN(Deep Neural Network):人間の脳の神経回路を参考にした「ニューラルネットワーク」を多層にした機械学習の仕組み。
※4: NPU(Neural Processing Unit):AMD SoCに搭載されたAIの推論処理を効率よく実行するためのプロセッサー。
※5: AMD Vivado Design Suite:AMD社が提供する、FPGAやアダプティブSoC(※7)の設計・開発に使うツール群。ハードウェアの設計や検証、デバイスに書き込むデータの生成などに利用される。
※6: Yocto(Yocto Project):組み込み機器向けのLinuxシステムを構築するためのオープンソースプロジェクト。
※7: アダプティブSoC:CPUなどに加え、用途に応じて構成できるプログラマブルな回路を備えたSoC。AMDの「Versal Adaptive SoC」が該当する。
次回のブログ更新は12月を
予定しています。お楽しみに!
- ※記載されている会社名、製品名は、各社の商標または登録商標です。
- ※ここに記載されている仕様、デザインなどは予告なしに変更する場合があります。